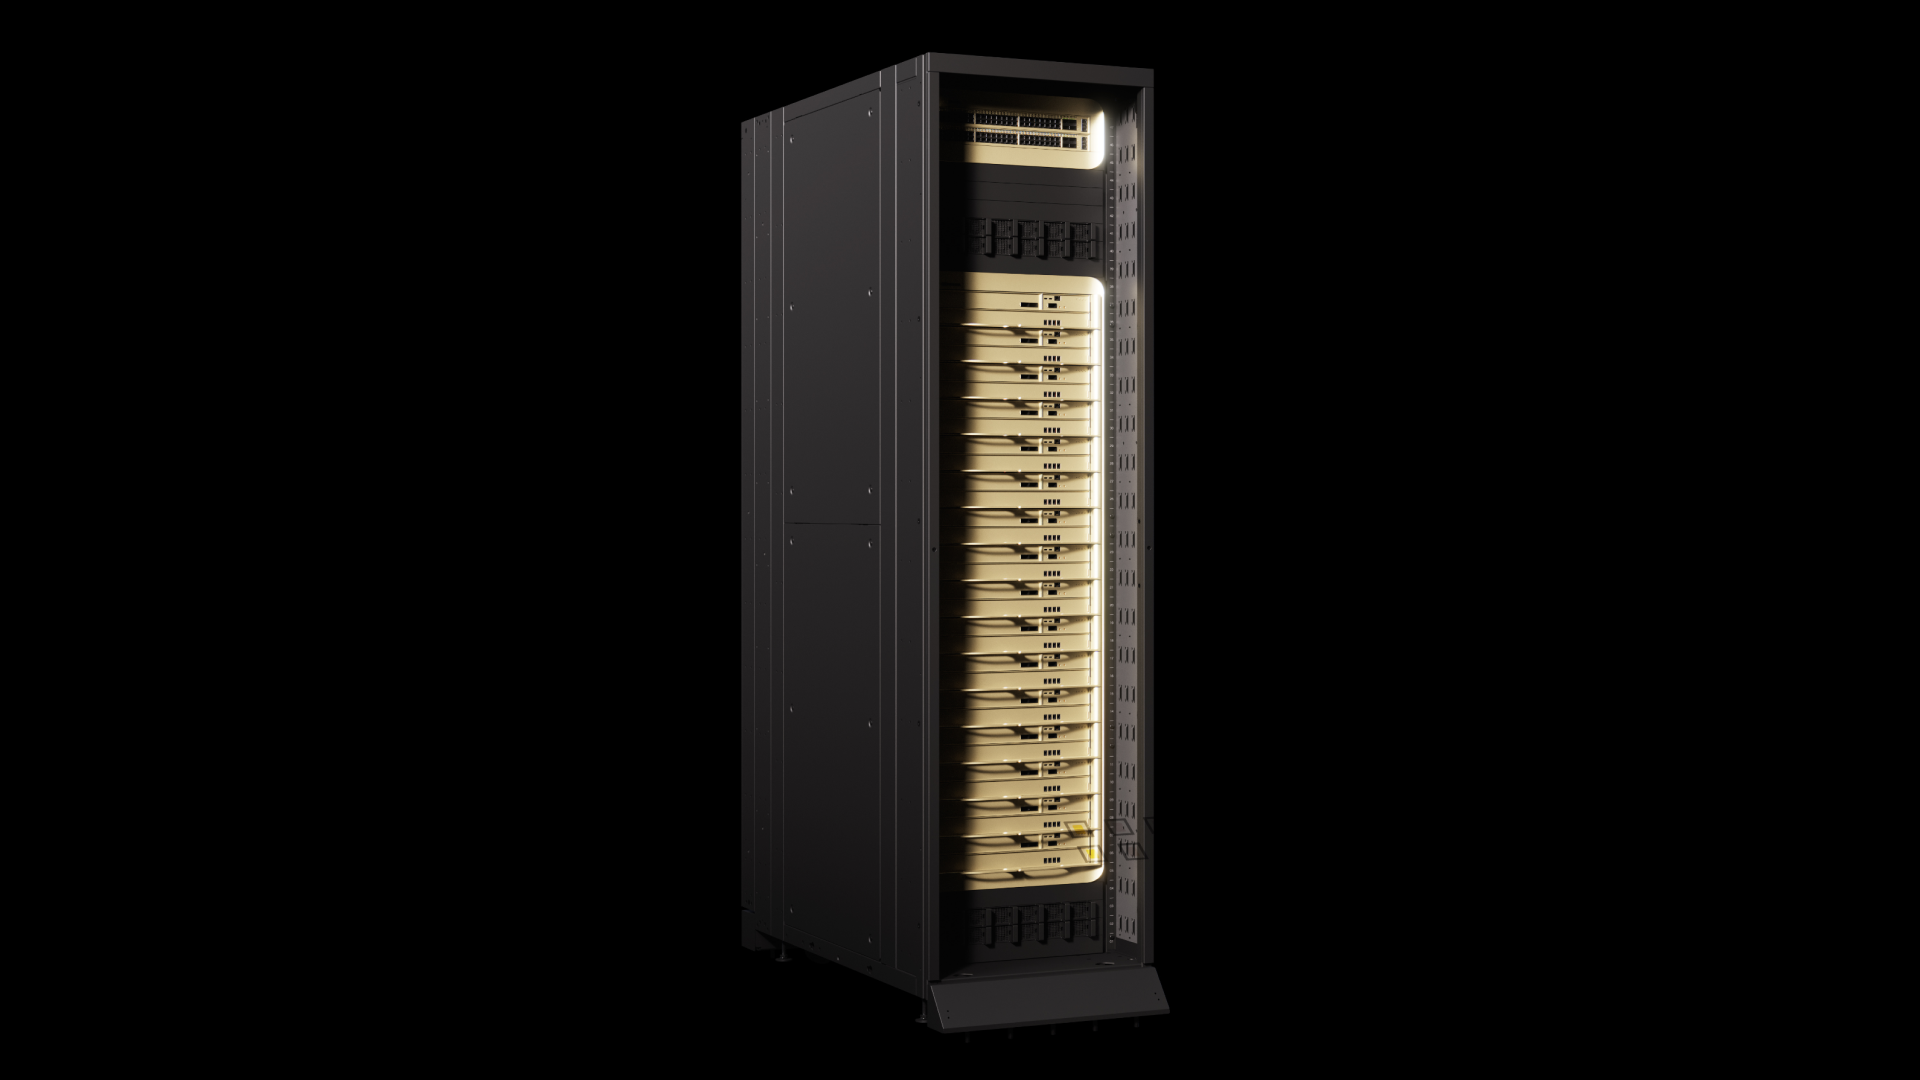
2026年8月24日、NVIDIA は対話型 AI 推論アクセラレータ「NVIDIA Groq 3 LPX」のフル生産を開始したと発表した。Vera Rubin NVL72 システムの推論性能を拡張し、エージェントシステムの高速なトークン生成を実現する。
NVIDIA が本日発表した Groq 3 LPX は、AI エージェントが複雑なタスクをリアルタイムで処理するための基盤となる。エージェントは数百から数千回の推論ステップを経て大量のトークンを生成するため、その速度が応答性に直結する。同製品は Vera Rubin NVL72 システムの性能を引き上げ、文脈を重視したワークロードでもプレミアムなユーザー体験を提供する。
Benchmarking 結果によると、Gemma 4 31B というオープンソースのエージェントモデルで 10 万トークンのコンテキストを処理する際、3,400 トークン/秒という記録的な速度を達成した。これは同モデルにおける最速の性能であり、コード生成などのエージェントタスクを時間単位から分単位で完了可能にする。また、競合プラットフォームと比べて応答性が 4 倍高速化されている。
AI クラウド事業者である Nebius は、この Groq 3 LPX を自社プロダクション推論プラットフォーム「Nebius Token Factory」に採用する初めての事例となる。開発者は既存の API を使い続けることで、エージェント処理の各ステップを瞬時に実行できる環境が提供される。その後の展開として、専用 AI 推論クラウドの Groq も早期採用を見込んでいる。
Vera Rubin プラットフォームは 7 つのチップと 5 種類の専用ラックから構成され、マルチエージェントシステム向けにワットあたりのスループット最大化と低遅延推論を最適化する。BlueField-4 DPUs や Spectrum-6 SPX Ethernet などのハードウェアと連携し、AI ファクトリのワークロード要件に対応する。