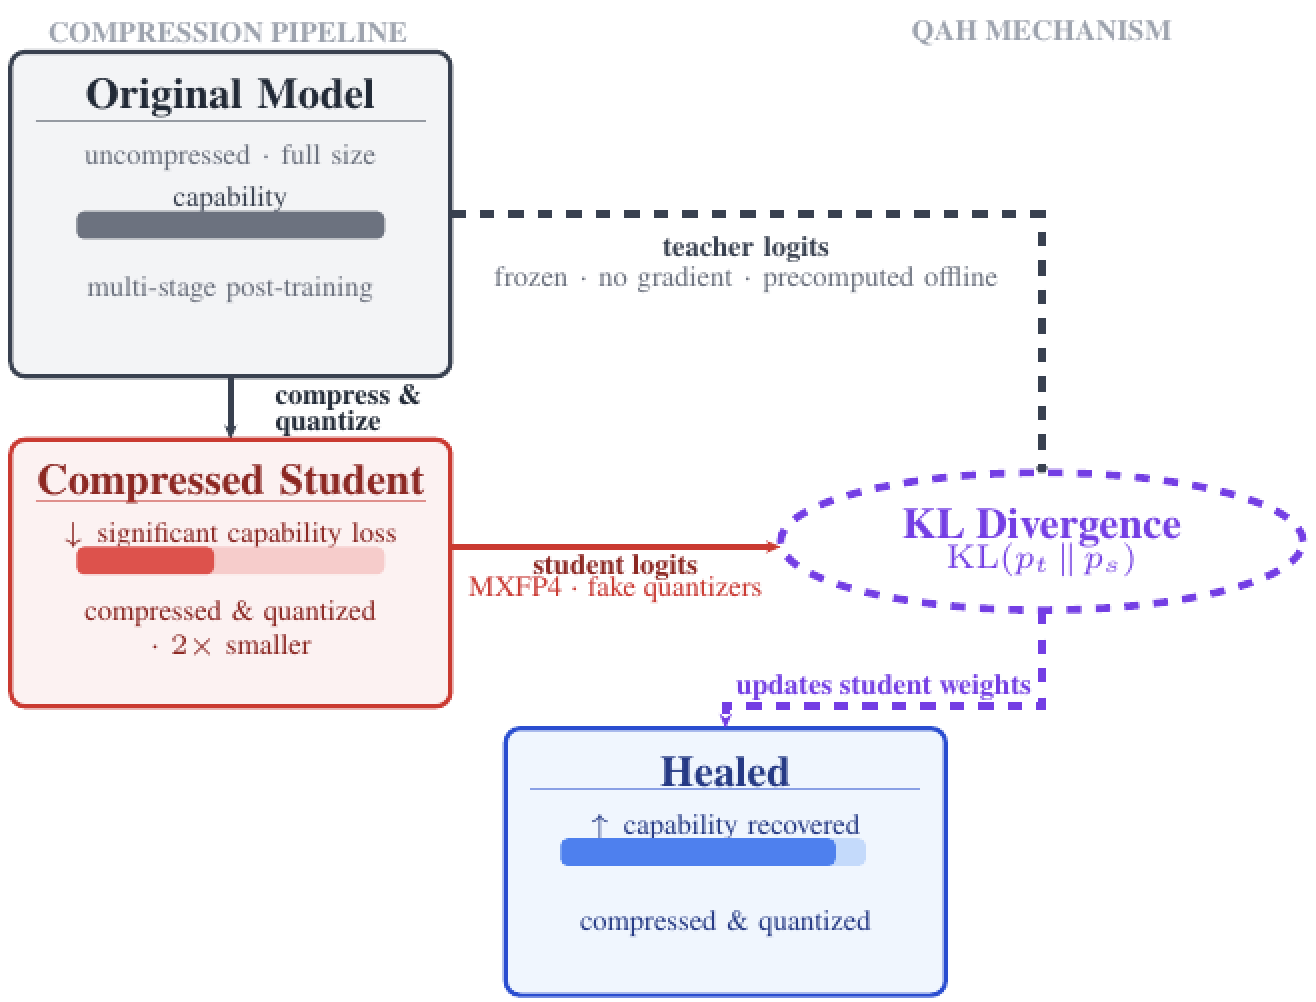
Multiverse Computingは、構造圧縮と量子化を施した大規模言語モデル(LLM)の精度を回復させる手法「Quantization-Aware Healing(QAH)」に関する論文を公開しました。この手法は、圧縮済みのモデルが本来の性能を維持、あるいは向上させることを目指しています。
圧縮モデルの精度を逆転させる新手法
QAHは、構造圧縮と量子化の両方を受けたモデルに対し、元の巨大なモデルから直接知識を蒸留する手法です。GPT-OSS 120Bモデルを60Bに構造圧縮し、さらにMXFP4形式で4ビット量子化したケースにおいて、QAHを適用したモデルは、量子化前の16ビット(bfloat16)版よりも9つのベンチマークのうち7つで高いスコアを記録しました。これにより、4ビットモデルが元の16ビットモデルよりも小さく、実行コストが低く、かつ高精度であるという、従来の関係性を覆す結果を得たと説明しています。
従来の蒸留手法との違い
従来の量子化認識蒸留(QAD)では、構造圧縮後のモデルを対象とする場合、圧縮後のモデルを教師として使用するため、精度の限界が圧縮後のモデルに縛られていました。これに対しQAHは、構造圧縮前のフルサイズのモデルを直接の教師として使用します。教師と生徒でアーキテクチャが異なっていても、出力分布を一致させることで知識の転送が可能になると述べています。
学習の安定性と効率性の向上
QAHは学習の安定性においても利点があるとされています。従来の量子化認識トレーニング(QAT)がタスク損失を用いて学習を続けるため、ピークを過ぎると精度が急落するリスクがあるのに対し、QAHは教師の分布に固定されるため、精度がドリフト(逸脱)しにくいとしています。また、QAHはQATと比較して、ピークに達するまでのステップ数が約7分の1と、高速な学習が可能であるとしています。
高いコンテキスト長への対応
QAHは、最大32,000トークンの長いコンテキストを持つドキュメントを用いた学習にも対応しています。メモリ効率の高いKLダイバージェンス損失を用いることで、限られたGPUメモリの予算内で、長いシーケンスの学習を可能にしています。これにより、圧縮によって損なわれやすい長文の推論能力などの回復に寄与すると説明しています。